
إزالة الغموض عن الصوت المحيط: كيف تعالج مساعدات الصوت كلماتك وتدير بيانات السحابة

معضلة الحوسبة المحيطية
على مدار العقد الماضي، قامت السماعات الذكية والأجهزة المفعلة صوتياً بهدوء بتحويل المساحات المنزلية إلى مراكز حوسبة محيطية مترابطة. فمن طاولات المطابخ إلى طاولات النوم، تقبع ملايين ميكروفونات الأنظمة الكهروميكانيكية الدقيقة (MEMS) مستعدة لالتقاط الإشارات الصوتية القصيرة مثل "Alexa" أو "Hey Google" أو "Siri". ومع ذلك، إلى جانب هذه الراحة واسعة الانتشار، يظل هناك شعور مستمر بالقلق. وغالباً ما يتساءل المستهلكون والمهندسون على حد سواء: ماذا يعني حقاً أن يكون الجهاز "يستمع دائماً"، وأين تكمن الحدود بين المعالجة المحلية على الحافة والرفع إلى السحابة؟
بالنسبة لمطوري البرمجيات، ومهندسي النظم، والتقنيين المهتمين بالخصوصية، يُعد فهم هذا التوازن أمراً بالغ الأهمية. فمنصات المساعد الصوتي ليست ببساطة أدوات تسجيل سلبية، كما أنها لا تقوم باستمرار برفع أربع وعشرين ساعة من الصوت المنزلي الخام إلى خوادم بعيدة. وبدلاً من ذلك، فهي تعمل على خط أنابيب معسي متعدد المراحل مصمم لتحقيق التوازن بين قيود طاقة الأجهزة الشديدة، ومعالجة اللغات الطبيعية في الوقت الفعلي (NLP)، ومتطلبات الأمان الصارمة. ويكشف تفكيك هذه البنية المعمارية عن الإعجاز التقني للاستماع المحيطي والأهمية الحرجة لحوكمة بيانات المستخدم.
كلمة التنبيه: الكشف على الحافة مقابل البث السحابي
الآلية الأساسية التي تحكم السماعات الذكية هي نموذج استماع من مرحلتين. ففي المرحلة الأولى، يعمل الجهاز بالكامل دون اتصال بالإنترنت على رقاقة محلية. وتغذي مصفوفة الميكروفونات مدخلات صوتية مستمرة في مخزن مؤقت صوتي صغير ومخصص - عادةً ما يخزن بضع ثوانٍ فقط من الصوت في أي لحظة معينة. ويتم الكتابة فوق هذا المخزن المؤقت باستمرار في الذاكرة ولا يلامس أبداً محرك الأقراص الثابتة أو واجهة الشبكة.
ويعمل فوق هذا المخزن المؤقت المحلي معالج إشارة رقمية (DSP) منخفض الطاقة للغاية أو متحكم دقيق ينفذ محرك كلمة تنبيه صوتية مدمج. وقد تم ضبط نموذج التعلم الآلي خفيف الوزن هذا خصيصاً التعرف على البصمة الصوتية لعبارة واحدة. ونظراً لأن هذه الخوارزميات تعمل محلياً على أجهزة رخيصة الثمن، فإنها لا تقوم بأي فهم دلالي؛ وتتمثل مهمتهم الوحيدة في مطابقة الأنماط الإحصائية. وحت يتم تجاوز عتبة الثقة الرياضية هذه، لا تغادر أي بيانات صوتية الجهاز المحلي.
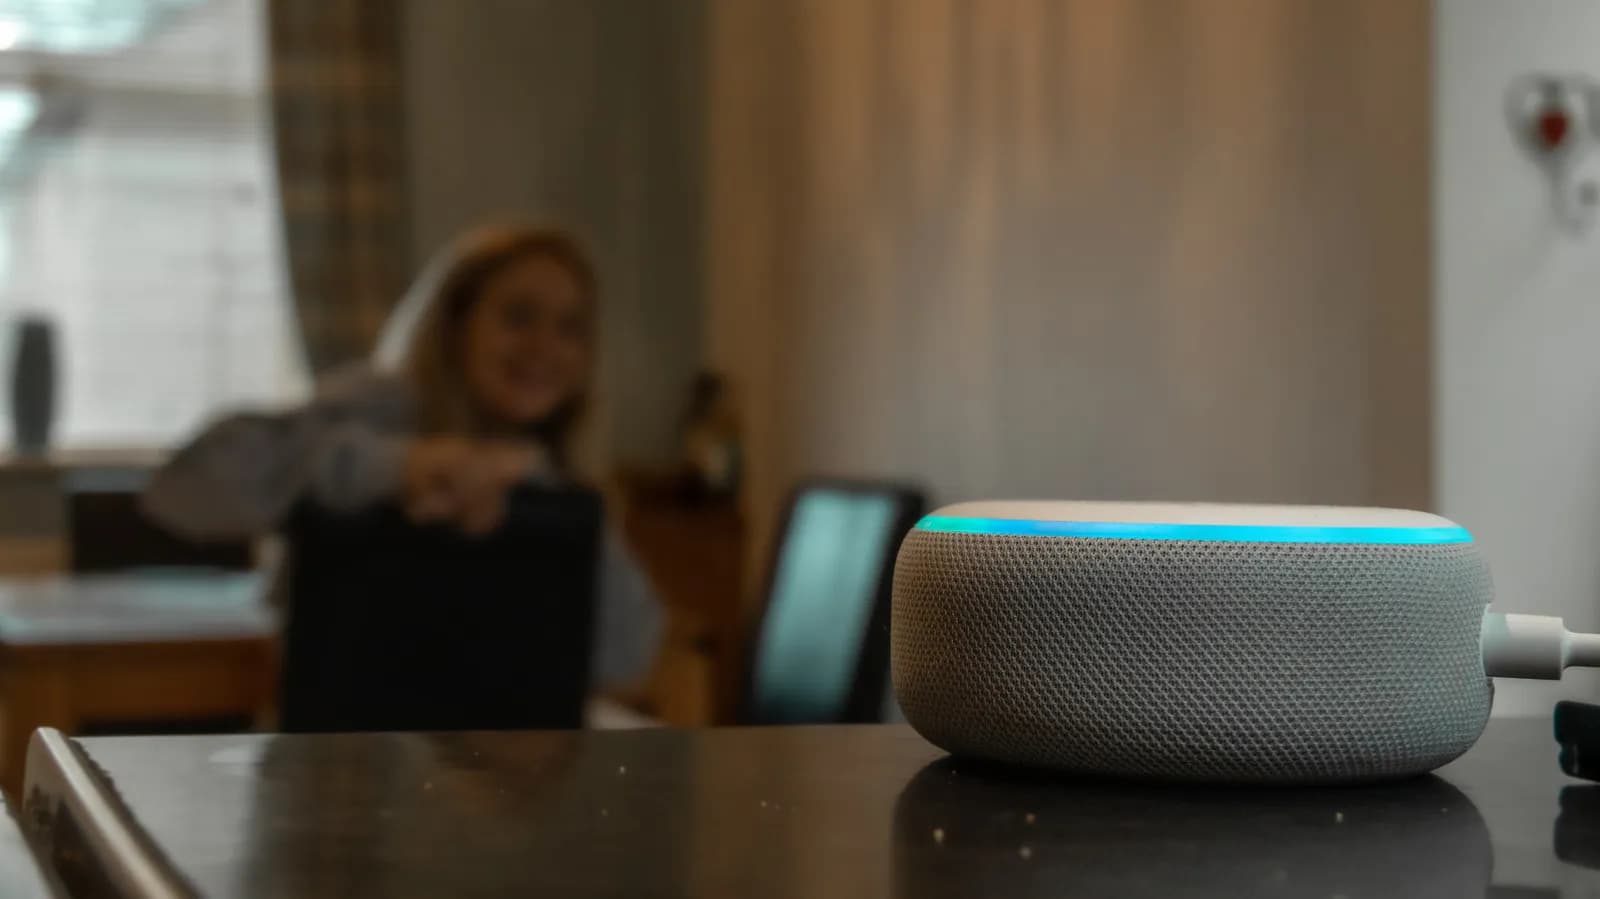
بمجرد اكتشاف كلمة التنبيه، يتم تنشيط المرحلة الثانية. ويقوم الجهاز بإضاءة مؤشر (مثل حلقة LED مرئية)، ويفتح اتصال أمان طبقة النقل (TLS) المشفر بخوادم السحابة، ويبدأ في بث الصوت. ويتضمن هذا البث الجزء اللاحق من كلمة التنبيه نفسها للسماح للمحرك السحابي بالتحقق من الاستدعاء، يليه أمر المستخدم اللاحق. وإذا حدد المحنف الصوتي الثانوي والأكثر تطوراً في السحابة أنه تم تشغيل كلمة التنبيه عن طريق الخطأ، يتم إنهاء الجلسة على الفور، والتخلص من البث.
خط الأنابيب السحابي: النسخ، والقصد، والاحتفاظ
بمجرد وصول الصوت إلى البنية التحتية السحابية، يخضع لمعالجة تحويل الكلام إلى نص عالية الإنتاجية وفهم اللغات الطبيعية (NLU). وتقوم الشبكات العصبية العميقة بتحويل الموجات الصوتية الخام إلى رموز نصية، والتي يتم تحليلها بعد ذلك إلى نوايا وكيانات وبارامترات. وإذا طلب المستخدم ظروف الطقس أو تبديل المفاتيح الذكية، توجيه الخدمات المصغرة تلك الطلبات إلى الواجهات الخلفية لـ API ذات الصلة، وجلب الحمولة، وتركيب استجابة منطوقة عبر تحويل النص إلى كلام (TTS)، ونقل حزمة الصوت مرة أخرى إلى السماعة الذكية.
ويتمثل الاختلاف الحاسم في كيفية عمل منصات الصوت في ما يحدث للصوت بعد تلبية النية الفورية. وتاريخياً، كان مقدمو الخدمات السحابية يحتفظون بشكل روتيني بالتسجيلات الصوتية الخام والنصوص المرتبطة بها إلى أجل غير مسمى بشكل افتراضي. وخدمت هذه الأرشيفات غرضين: تزويد المستخدمين بتاريخ أوامر سهل الوصول وتزويد فرق الهندسة ببيانات صوتية حقيقية لتدريب وضبط نماذج التعرف الآلي على الكلام.
ومع ذلك، فقد أدى تدقيق الصناعة وتشديد لوائح البيانات العالمية إلى تحويل هذا النموذج نحو التحكم الحبيبي للمستخدم. وتوفر المنصات الحديثة مفاتيح صريحة تسمح للمستهلكين بتحديد ما إذا كانت نصوص الصوت والتسجيلات الخام يتم تخزينها، أو تطهيرها تلقائياً بعد نوافذ الاحتفاظ المحددة (مثل ثلاثة أو ثمانية عشر شهراً)، أو حذفها فوراً عند المعالجة. وعلاوة على ذلك، توجد خيارات لالغاء الاشتراك في برامج المراجعة البشرية اليدوية، والتي كانت تعتمد سابقاً على مقاولين متعاقدين لتدقيق مقاطع الصوت مجهولة الهوية لدقة التدريب.
ضوابط الخصوصية ونوذج مسؤولية المستخدم
في حين أن التمييز المعماري بين مراقبة كلمة التنبيه على الحافة والبث السحابي يمنع المراقبة الجماعية المستمرة، فإن نموذج الخصوصية يعتمد في النهاية على التكوين والقبول. وخارج الصندوق، غالباً ما تعطي التكوينات الافتراضية الأولوية لتحسين النظام والتخصيص على نظافة البيانات دون أي أثر. ونتيجة لذلك، تقع المسؤولية غالباً على المستخدمين ومسؤولي النظام لتنظيم إعدادات بياناتهم بنشاط.
داخل لوحات تحكم إدارة الجهاز، يمكن للمستخدمين تدقيق التفاعلات السابقة، وتشغيل التسجيلات الصوتية المخزنة، وتطهير القياس عن بعد التاريخي. وبالنسبة للمطور المهتم بالخصوصية، فإن تعطيل تخزين الصوت تماماً يحول منصة الصوت إلى معالج استعلام عابر. وفي حين أن هذا يقلل قليلاً من المعايرة الصوتية المخصصة بمرور الوقت، إلا أنه يخفف بشكل فعال من مخاطر تعرض سجلات الصوت التاريخية في خروقات البيانات، أو استدعائها في الاكتشاف القانوني، أو الوصول إليها بطريق الخطأ من قبل مقاولي الطرف الثالث.
وعلاوة على ذلك، تتضمن الأجهزة الحديثة تخفيفات مادية للخصوصية. تتميز معظم الأجهزة الممكنة صوتياً بمفاتيح كتم صوت الميكروفون على مستوى الأجهزة التي تفصل مادياً سكة الطاقة عن مصفوفة الميكروفون أو تسحب خط الصوت إلى الأرض. وعلى عكس التبديل المستند إلى البرامج، يضمن حالة الكتم المعزولة للأجهزة أن معالج الإشارة الرقمية (DSP) لا يمكنه استقبال إشارات صوتية تناظرية، مما يوفر حاجزاً مقاوماً للعبث ضد التنشيط غير المقصود.
الدروس المعمارية لإنترنت الأشياء ومهندسي الصوت
يقدم الحوار الجاري حول مراقبة السماعة الذكية دروساً قيمة للمهندسين الذين يبنون أنظمة إنترنت الأشياء وأجهزة الحافة من الجيل التالي. وأولاً وقبل كل شيء مبدأ الحد الأدنى القائم على الحافة. إن نقل البيانات البيometric الخام - مثل الصوت أو الفيديو أو محيط الوجه - إلى السحب البعيدة يتكبد تأخيراً كبيراً، وتكاليف النطاق الترددي، والالتزامات التنظيمية بموجب أطر مثل GDPR و CCPA.
تتجه فرق الهندسة الحديثة بشكل متزايد نحو الذكاء على الجهاز. ومع رخص وحدات المعالجة العصبية (NPUs) وأكثر كفاءة في استهلاك الطاقة، يمكن للمطورين نشر نماذج التعرف على الكلام المحلية الكمية مباشرة على أجهزة الحافة. ومن خلال تنفيذ التعرف على كلمة التنبيه وتصنيف النية الأساسية على أجهزة العميل، يمكن للتطبيقات تنفيذ أوامر محلية (مثل تعديلات الإضاءة الذكية أو تشغيل الوسائط) بتأخير يقترب من الصفر ودون إرسال بايت واحد من الصوت عبر الإنترنت العام.
وعندما يكون الاتصال السحابي ضرورياً تماماً، يجب التعامل مع الشفافية متطلباً معماريهاً من الدرجة الأولى. يجب أن تنفذ الأنظمة إشارات القياس عن بعد الواضحة - كلا المؤشرات المرئية والتسجيل القابل للوصول - كلما حدث خروج البيانات. يجب دمج تدفقات الاشتراك الصريح للاحتفاظ بالبيانات، وسياسات دورة الحياة الآلية التي تفرض انتهاء صلاحية البيانات، والتشفير القوي من جانب العميل افتراضياً بدلاً من معاملتها كإصلاحات امتثال ما بعد الإطلاق.
الحدود التالية: نماذج اللغة الكبيرة على الحافة والذكاء المحلي
بالنظر إلى المستقبل، فإن تقارب التعلم الآلي الصغير (TinyML) ونماذج اللغة الكبيرة المدمجة مستعد لإعادة تعريف نظام البيئة الصوتية المحيطية. وفي حين اعتمدت السماعات الذكية القديمة على مراكز البيانات السحابية لأن المتحكمات الدقيقة الصغيرة لم تستطع تشغيل شبكات عصبية ذات مليارات المعلمات، فإن الظهور السريع لسيليكون الحافة عالي الأداء يغير المشهد. ويمكن لنماذج اللغة المدمجة القادرة على العمل داخل ذاكرة النظام المحلي التعامل الآن مع السياق المحادثة والاستعلامات المعقدة دون تبعية سحابية دائمة.
يمثل هذا الانتقال فوزاً عميقاً للخصوصية والمرونة النظامية. يمكن للأجهزة التي تشغل نماذج محلية أن تظل تعمل بشكل كامل خلال انقطاع الإنترنت، والقضاء على تأخير رحلة الذهاب والإياب للشبكة، والقضاء تماماً على مخاطر الخصوصية المرتبطة بتخزين الصوت المركزي. وفي هذا النموذج الناشئ، تتوقف الحوسبة المحيطية عن كونها ميكروفوناً مفتوحاً مقيداً بسحابة الشركة، وتتطور بدلاً من ذلك إلى مساعد رقمي مستقل يحافظ على الخصوصية.
الملخص والأفكار النهائية
أجهزة الاستماع المحيطية لا تبث الصوت المنزلي باستمرار، ولكن اعتمادها على خطوط أنابيب الكلام المستندة إلى السحابة يجعل الإشراف على البيانات شاغلاً قصوى. ويخلق الجمع بين مرشحات كلمة التنبيه المستندة إلى الحافة وفهم اللغات الطبيعية السحابي واجهة صوتية فعالة، ولكنه يتطلب من المستخدمين إدارة مفاتيح الاحتفاظ بالبيانات وضوابط إلغاء الاشتراك بشكل استباقي. وبالنسبة لمجتمع المطورين، فإن المسار الواضح يتجه نحو المعالجة المحلية: تصميم الأنظمة التي تحسب أقرب إلى المستخدم، وتقليل الاحتفاظ بالبيانات، ومعاملة الخصوصية ليس كإعداد للمستخدم، ولكن أساساً معماريها متأصلاً.
المصدر: engadget.com