
Démystifier l'audio ambiant : comment les assistants vocaux traitent vos mots et gèrent les données cloud

Le dilemme de l'informatique ambiante
Au cours de la dernière décennie, les enceintes intelligentes et les appareils à commande vocale ont transformé discrétionnairement les foyers en véritables hubs informatiques ambiants interconnectés. Des comptoirs de cuisine aux tables de chevet, des millions de microphones MEMS (systèmes micro-électromécaniques) se tiennent prêts à capturer de brefs indices vocaux tels que « Alexa », « Hey Google » ou « Siri ». Pourtant, cette commodité omniprésente s'accompagne d'un sentiment persistant d'inconfort. Consommateurs et ingénieurs se demandent fréquemment ce que signifie réellement le fait qu'un appareil soit « toujours à l'écoute », et où se situe la frontière entre le traitement local en périphérie (edge) et l'ingestion dans le cloud.
Pour les développeurs logiciels, les architectes systèmes et les technologues soucieux de la vie privée, il est essentiel de comprendre cet équilibre. Les plateformes vocales ne sont pas de simples instruments d'enregistrement passifs, et elles ne téléchargent pas non plus en continu vingt-quatre heures d'audio domestique brut vers des serveurs distants. Au lieu de cela, elles fonctionnent via un pipeline multi-étapes complexe conçu pour concilier des contraintes matérielles extrêmes, le traitement automatique du langage naturel (NLP) en temps réel et des exigences de sécurité rigoureuses. Décortiquer cette architecture révèle à la fois la merveille technique de l'écoute ambiante et l'importance critique de la gouvernance des données utilisateur.
Le mot d'activation : détection en périphérie ou diffusion cloud
Le mécanisme fondamental qui régit les enceintes intelligentes repose sur un modèle d'écoute en deux phases. Dans la première phase, l'appareil fonctionne entièrement hors ligne sur le silicium local. Le réseau de microphones alimente en continu un petit tampon audio dédié, stockant généralement seulement quelques secondes de son à un moment donné. Ce tampon est constamment écrasé en mémoire et ne touche jamais un disque dur ou une interface réseau.
Au-dessus de ce tampon localisé s'exécute un processeur de signal numérique (DSP) ou un microcontrôleur à ultra-faible consommation qui exécute un moteur de détection de mot d'activation (wake word) acoustique intégré. Ce modèle d'apprentissage automatique léger est spécifiquement réglé pour reconnaître la signature phonétique d'une seule phrase. Étant donné que ces algorithmes s'exécutent localement sur du matériel à faible coût, ils n'effectuent aucune compréhension sémantique ; leur seule tâche est la correspondance de motifs statistiques. Tant que ce seuil mathématique de confiance n'est pas franchi, aucune donnée audio ne quitte l'appareil local.
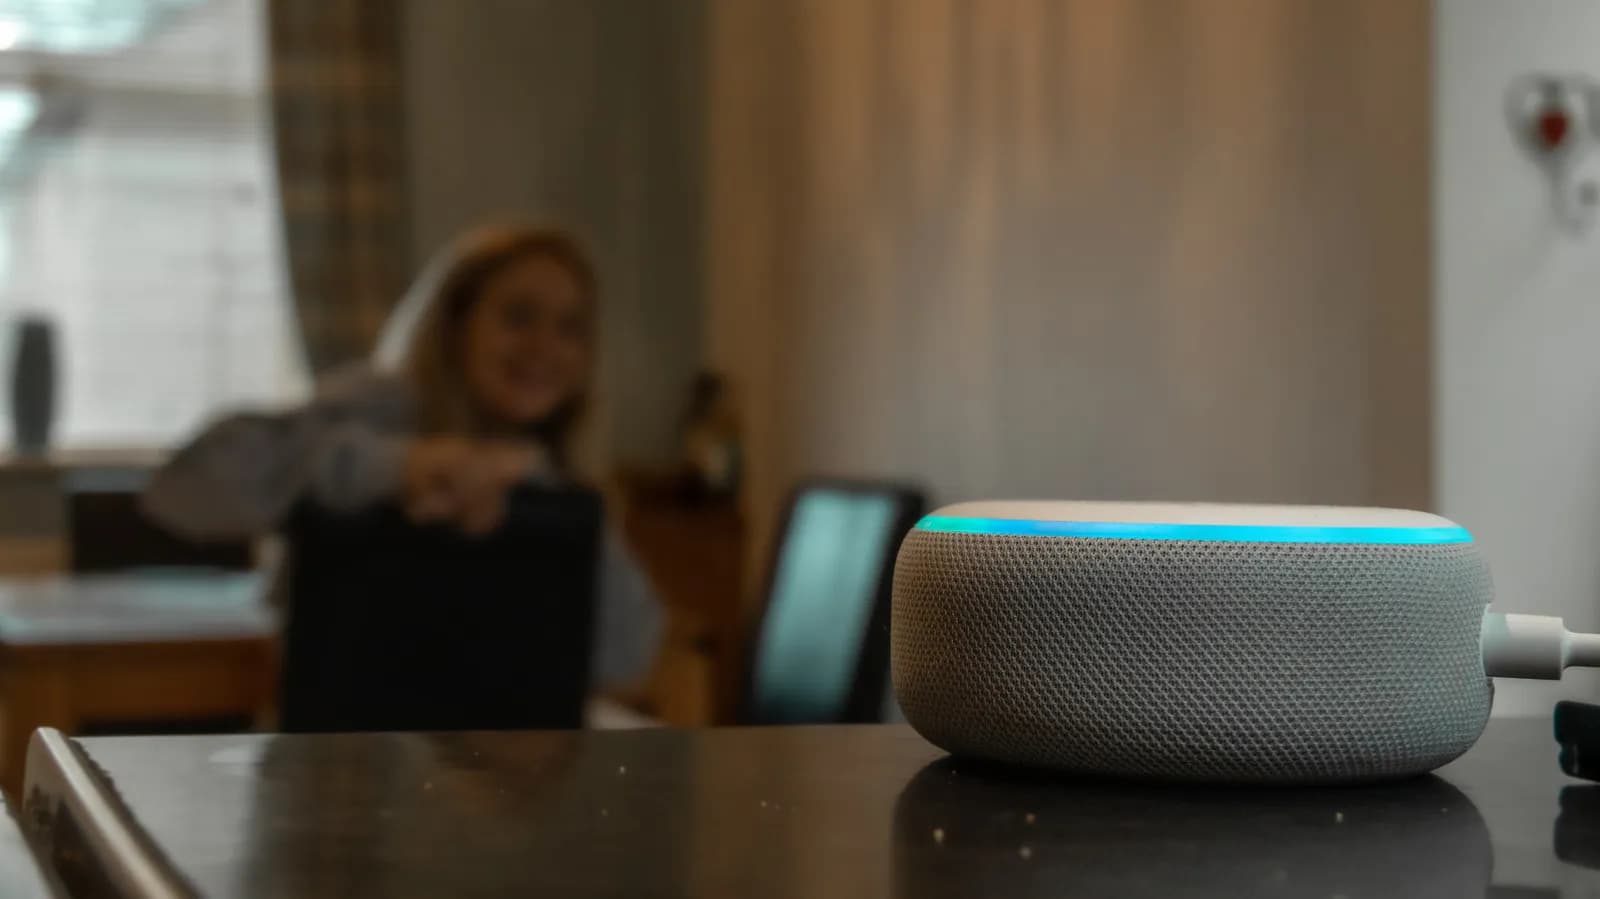
Une fois le mot d'activation détecté, la seconde phase s'active. L'appareil allume un indicateur (tel qu'un anneau LED visuel), ouvre une connexion TLS (Transport Layer Security) chiffrée vers les serveurs cloud et commence à diffuser l'audio. Ce flux comprend le fragment final du mot d'activation lui-même pour permettre au moteur cloud de vérifier l'appel, suivi de la commande ultérieure de l'utilisateur. Si le classificateur acoustique secondaire et plus sophistiqué du cloud détermine que le mot d'activation a été déclenché par erreur, la session est immédiatement interrompue et le flux est supprimé.
Le pipeline cloud : transcription, intention et rétention
Une fois que l'audio atteint l'infrastructure cloud, il subit un traitement de conversion de la parole en texte à haut débit et une compréhension du langage naturel (NLU). Des réseaux de neurones profonds convertissent les formes d'onde acoustiques brutes en jetons textuels, qui sont ensuite analysés pour en extraire les intentions, les entités et les paramètres. Si un utilisateur demande les conditions météorologiques ou l'activation d'un interrupteur intelligent, les microservices acheminent ces requêtes vers les backends API concernés, récupèrent la charge utile, synthétisent une réponse vocale via la synthèse vocale (TTS) et transmettent le paquet audio à l'enceinte intelligente.
La divergence critique dans le fonctionnement des plateformes vocales réside dans ce qu'il advient de l'audio une fois l'intention immédiate satisfaite. Historiquement, les fournisseurs de cloud conservaient par défaut et indéfiniment les enregistrements vocaux bruts ainsi que les transcriptions textuelles associées. Ces archives servaient un double objectif : offrir aux utilisateurs un historique des commandes accessible et fournir aux équipes d'ingénierie des données acoustiques du monde réel pour entraîner et affiner les modèles de reconnaissance automatique de la parole.
Cependant, la surveillance de l'industrie et le durcissement des réglementations mondiales sur les données ont orienté ce paradigme vers un contrôle granulaire de l'utilisateur. Les plateformes modernes offrent des interrupteurs explicites permettant aux consommateurs de déterminer si les transcriptions vocales et les enregistrements bruts sont stockés, automatiquement purgés après des fenêtres de rétention désignées (telles que trois ou dix-huit mois), ou supprimés immédiatement après le traitement. En outre, il existe des options pour se désengager des programmes de révision humaine manuelle, qui reposaient auparavant sur des évaluateurs sous contrat pour auditer des extraits audio anonymisés afin d'améliorer la précision de l'entraînement.
Contrôles de confidentialité et modèle de responsabilité de l'utilisateur
Bien que la distinction architecturale entre la surveillance des mots d'activation en périphérie et la diffusion cloud empêche une surveillance de masse constante, le modèle de confidentialité dépend en fin de compte de la configuration et du consentement. Dès la sortie de la boîte, les configurations par défaut privilégient souvent l'amélioration du système et la personnalisation au détriment d'une hygiène des données sans empreinte. Par conséquent, la responsabilité incombe fréquemment aux utilisateurs et aux administrateurs système d'ajuster activement leurs paramètres de données.
Dans les tableaux de bord de gestion des appareils, les utilisateurs peuvent auditer les interactions passées, écouter les enregistrements audio stockés et purger la télémétrie historique. Pour le développeur soucieux de la confidentialité, la désactivation totale du stockage audio transforme la plateforme vocale en un processeur de requêtes éphémère. Bien que cela réduise légèrement l'étalonnage vocal personnalisé au fil du temps, cela atténue efficacement le risque que les journaux vocaux historiques soient exposés lors de violations de données, assignés à comparaître dans le cadre d'une procédure judiciaire ou consultés par erreur par des sous-traitants tiers.
De plus, le matériel moderne intègre des mesures d'atténuation de la confidentialité physiques. La plupart des appareils à commande vocale sont dotés d'interrupteurs de désactivation du microphone au niveau matériel qui découplent physiquement le rail d'alimentation du réseau de microphones ou mettent la ligne audio à la masse. Contrairement aux boutons logiciels, un état de sourdine isolé matériellement garantit que le DSP ne peut pas recevoir de signaux acoustiques analogiques, offrant ainsi une barrière inviolable contre toute activation involontaire.
Leçons architecturales pour les ingénieurs IoT et vocaux
Le dialogue en cours entourant la surveillance des enceintes intelligentes offre de précieuses leçons aux ingénieurs qui construisent des systèmes IoT de nouvelle génération et du matériel en périphérie. Le premier et le plus important est le principe de minimisation centrée sur la périphérie. Transporter des données biométriques brutes — telles que la voix, la vidéo ou les contours du visage — vers des clouds distants entraîne une latence substantielle, des coûts de bande passante et des responsabilités réglementaires en vertu de cadres tels que le RGPD et le CCPA.
Les équipes d'ingénierie modernes se tournent de plus en plus vers l'intelligence sur l'appareil. À mesure que les unités de traitement neural (NPU) deviennent moins chères et plus économes en énergie, les développeurs peuvent déployer des modèles de reconnaissance vocale locaux quantifiés directement sur les appareils de périphérie. En exécutant à la fois la reconnaissance des mots d'activation et la classification des intentions de base sur le matériel client, les applications peuvent exécuter des commandes locales (telles que des réglages d'éclairage intelligent ou la lecture multimédia) avec une latence quasi nulle et sans transmettre un seul octet d'audio sur Internet public.
Lorsque la communication cloud est strictement nécessaire, la transparence doit être traitée comme une exigence architecturale de premier ordre. Les systèmes doivent mettre en œuvre des signaux de télémétrie clairs — à la fois des indicateurs visuels et des journaux accessibles — chaque fois qu'une sortie de données se produit. Des flux d'acceptation explicites pour la conservation des données, des politiques de cycle de vie automatisées qui appliquent l'expiration des données et un chiffrement robuste côté client doivent être intégrés par défaut plutôt que traités comme des correctifs de conformité post-lancement.
La prochaine frontière : LLM en périphérie et intelligence localisée
À l'avenir, la convergence du tiny machine learning (TinyML) et des grands modèles de langage compacts est sur le point de redéfinir l'écosystème vocal ambiant. Alors que les enceintes intelligentes historiques s'appuyaient sur des centres de données cloud parce que les petits microcontrôleurs ne pouvaient pas exécuter des réseaux de neurones à plusieurs milliards de paramètres, l'émergence rapide de silicium de périphérie haute performance modifie le paysage. Les modèles de langage compacts capables de s'exécuter dans la mémoire système locale peuvent désormais gérer le contexte conversationnel et les requêtes complexes sans dépendance perpétuelle au cloud.
Cette transition représente une victoire profonde pour la confidentialité et la résilience du système. Les appareils exécutant des modèles locaux peuvent rester pleinement opérationnels lors de pannes Internet, éliminer la latence des aller-retours réseau et supprimer fondamentalement les risques de confidentialité associés au stockage audio centralisé. Dans ce paradigme émergent, l'informatique ambiante cesse d'être un microphone ouvert relié à un cloud d'entreprise, pour évoluer vers un assistant numérique autonome et respectueux de la vie privée.
Résumé et dernières réflexions
Les dispositifs d'écoute ambiante ne diffusent pas en permanence l'audio domestique, mais leur dépendance à l'égard des pipelines vocaux basés sur le cloud fait de la gestion des données une préoccupation primordiale. La combinaison de filtres de mots d'activation basés sur la périphérie et de NLU cloud crée une interface vocale efficace, mais elle oblige les utilisateurs à gérer de manière proactive les commutateurs de conservation des données et les contrôles de refus. Pour la communauté des développeurs, la trajectoire claire mène vers le traitement local : concevoir des systèmes qui calculent plus près de l'utilisateur, minimisent la rétention des données et traitent la confidentialité non pas comme un paramètre utilisateur, mais comme un fondement architectural inhérent.
Source: engadget.com