Discord étudie l'indexation par les moteurs de recherche pour les serveurs publics : ce que cela implique pour les développeurs et les communautés

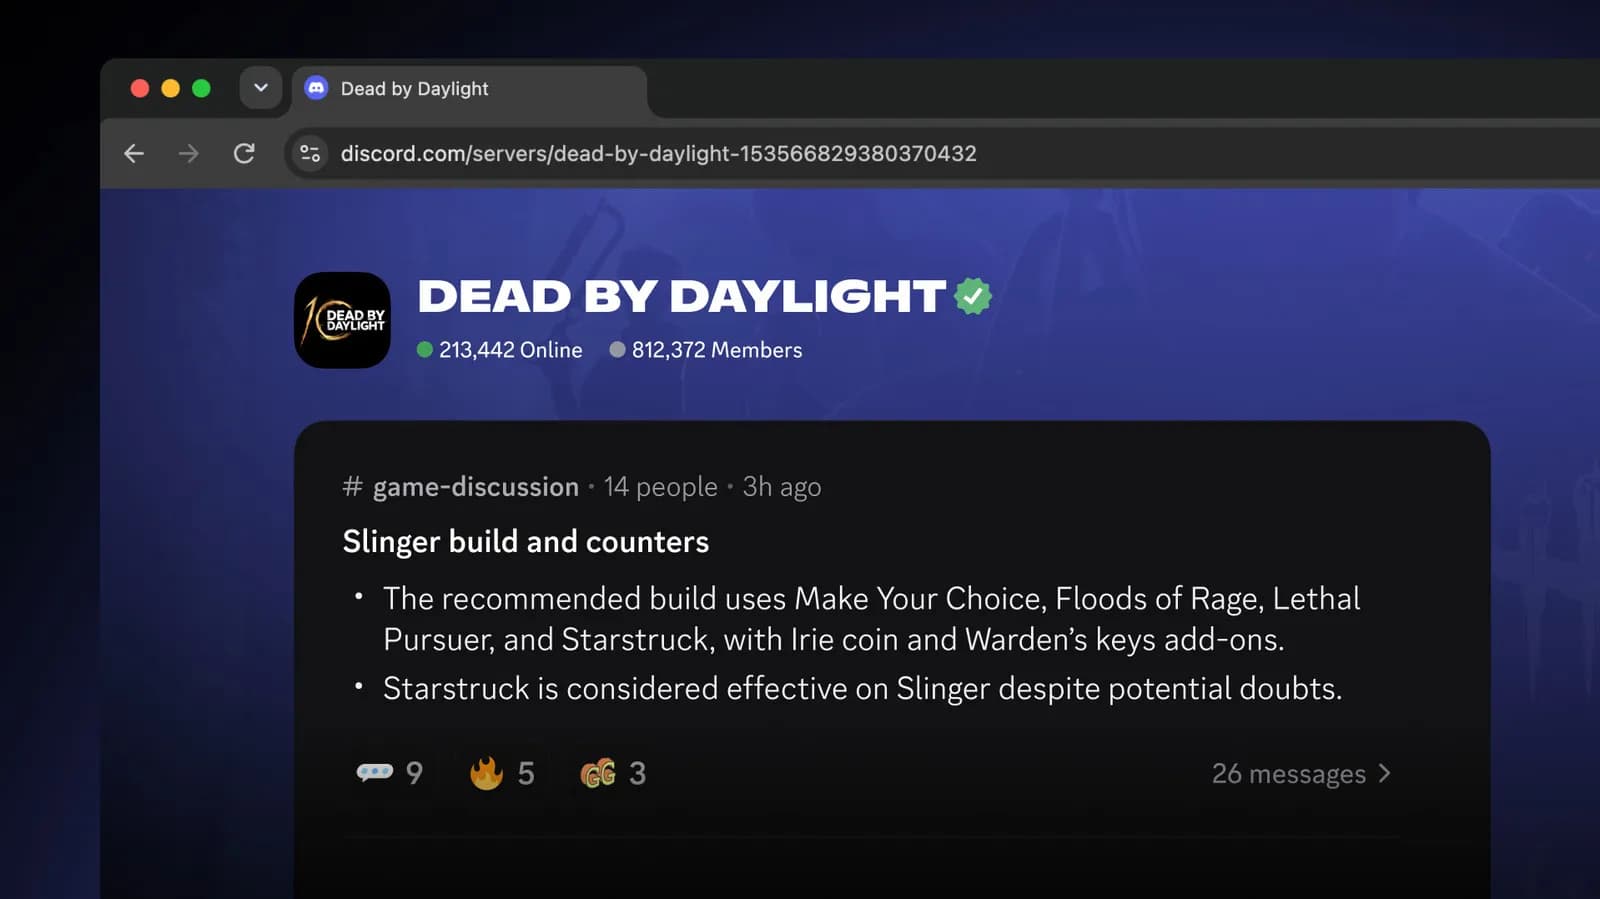
Pendant des années, Discord a occupé une place unique et parfois controversée dans l'écosystème Internet moderne. Initialement conçu comme une plateforme de chat vocal et textuel légère pour les joueurs en ligne, le service est discrètement devenu le foyer de facto des projets open-source, des écosystèmes de développeurs, des discussions sur les frameworks et des communautés Web3. Pourtant, malgré l'hébergement de millions d'échanges de dépannage, de conseils de débogage et de débats architecturaux, ce répertoire de résolution de problèmes humains est resté essentiellement invisible pour le reste du web — bloqué derrière un mur d'authentification dans ce que les technologues appellent fréquemment le web « social sombre » moderne. Cette dynamique est aujourd'hui sur le point de connaître un changement radical, alors que Discord se prépare à autoriser leాల్లో (exploration) et l'indexation des messages de serveurs publics et découvrables par des moteurs de recherche tels que Google.
Bien que la plateforme prévoie de fournir des contrôles de désactivation pour donner aux communautés l'autonomie nécessaire sur leur visibilité, cette transition marque l'un des changements structurels les plus importants de l'histoire de Discord. En ouvrant les canaux publics aux robots d'indexation du web, Discord se positionne pour concurrencer directement les logiciels de forums traditionnels, les portails de documentation et des plateformes telles que Reddit et Stack Overflow. Cependant, cette évolution introduit des compromis complexes concernant les attentes des utilisateurs, les normes de confidentialité, l'accessibilité de la documentation logicielle et la course pour alimenter les algorithmes de recherche et les pipelines de données d'intelligence artificielle.
La fin de l'ère du jardin clos de Discord
Depuis son lancement, le modèle architectural de Discord reposait sur des communautés fermées ou sur invitation appelées « guildes ». Même lorsque l'entreprise a introduit des fonctionnalités de découverte publique — permettant aux utilisateurs de parcourir et de rejoindre des serveurs dédiés à des langages de programmation largement utilisés, à des titres de jeux et à des outils de création —, le contenu réel de ces serveurs est resté protégé des robots d'indexation externes. Si un développeur passait trois jours à résoudre un bug de compilateur obscur dans le serveur Discord officiel d'un framework, cette précieuse avancée était complètement invisible pour quiconque tapait le même message d'erreur dans une barre de recherche Google.
Ce modèle fermé a créé des frictions généralisées dans le paysage du génie logiciel. Une plainte récurrente parmi les développeurs a été la cannibalisation constante des forums web traditionnels et des babillards électroniques par Discord. Les gestionnaires de communauté et les mainteneurs adoraient l'interaction en temps réel de Discord, ses riches intégrations de bots et ses canaux vocaux, mais les critiques ont souligné que le déplacement des discussions de support vers des salons de chat entraînait une perte nette pour l'internet ouvert. Les connaissances sont devenues éphémères, les questions répétitives ont proliféré et la mémoire institutionnelle interrogeable a disparu. Ouvrir les serveurs découvrables à l'indexation de recherche est l'effort le plus direct de Discord à ce jour pour résoudre cette tension structurelle.
Comment l'indexation des messages publics va fonctionner
Dans le cadre du mécanisme d'indexation proposé, seuls les serveurs qui se sont explicitement inscrits au programme Discovery de Discord — l'annuaire des communautés accessibles au public qui répondent à des directives strictes d'adhésion et de modération — seront éligibles pour que leur historique de chat soit indexé. En outre, Discord intègre des bascules administratives qui permettent aux opérateurs de serveurs de refuser la découverte par les moteurs de recherche, garantissant ainsi que les communautés souhaitant maintenir un degré relatif de confidentialité insulaire puissent le faire sans perdre leur découvrabilité générale dans le client Discord.
Du point de vue de la mise en œuvre technique, rendre les archives de chat visibles pour les moteurs de recherche implique de générer des représentations web propres, statiques ou rendues côté serveur, des fils de discussion. Les architectures d'applications monopage (SPA) traditionnelles qui reposent fortement sur l'état côté client et les WebSockets authentifiés sont notoirement difficiles à analyser efficacement pour les robots web. En exposant les fils de discussion des canaux publics sous forme de pages HTML indexables, Discord peut fournir aux moteurs de recherche comme Google des balises sémantiques, des URL canoniques et des données structurées, transformant ainsi efficacement les salons de discussion animés en documents web en lecture seule pour les visiteurs non connectés.
La perspective du développeur : faire surface aux connaissances enfouies
Pour les ingénieurs logiciels et les passionnés de technologie, la perspective de voir des messages Discord apparaître dans les résultats de recherche Google est largement une évolution bienvenue avec des avantages pratiques immédiats. Ces dernières années, la qualité des résultats des moteurs de recherche pour les requêtes techniques s'est visiblement dégradée, souvent encombrée par des fermes d'optimisation pour les moteurs de recherche (SEO), des sites web de web scraping générés automatiquement et des résumés de faible qualité qui ne parviennent pas à répondre à des questions techniques nuancées. Faire surface à de véritables discussions entre pairs où les ingénieurs résolvent les problèmes de mises à jour de bibliothèques, de drapeaux de configuration et de cas limites pourrait insuffler une nouvelle vie aux résultats de recherche techniques.
De nombreux mainteneurs open-source font actuellement face à une grave fatigue du support parce que les nouveaux arrivants posent à plusieurs reprises des questions qui ont reçu une réponse détaillée quelques jours plus tôt dans un autre canal. Bien que les bots communautaires et les forums de FAQ aient tenté d'atténuer ce fardeau, rien ne vaut l'efficacité d'un utilisateur trouvant de manière autonome une réponse via une requête de recherche avant même d'envisager de publier. Si les fils de discussion Discord peuvent se classer aux côtés des problèmes GitHub et des fils Stack Overflow, la courbe d'intégration des développeurs pour les frameworks et bibliothèques émergents pourrait devenir considérablement plus fluide.
Préoccupations en matière de confidentialité et recontextualisation du chat
Malgré les avantages fonctionnels, cette initiative soulève de profondes inquiétudes en matière de confidentialité et des défis liés au consentement des utilisateurs. Les plateformes de chat cultivent une atmosphère informelle et conversationnelle qui semble fondamentalement distincte de la publication d'un article ou de la rédaction d'une réponse sur un forum public. Lorsque des individus publient sur Discord, ils traitent fréquemment le média comme un chat en cours et semi-privé entre pairs, même lorsqu'ils savent que le serveur est techniquement ouvert à toute personne disposant d'un lien d'invitation.
Les messages indexés signifient que des remarques improvisées, des frustrations personnelles, des plaisanteries occasionnelles ou des opinions passées pourraient soudainement être liées à l'empreinte numérique persistante d'un individu et faire surface directement via son nom d'utilisateur dans les recherches web standard. Bien que des paramètres de désactivation soient disponibles pour les propriétaires de serveurs, les membres ordinaires détiennent rarement des privilèges administratifs. Si un administrateur de serveur choisit d'autoriser l'indexation, les utilisateurs individuels peuvent voir leurs contributions passées exposées aux robots de recherche, à moins que des contrôles de confidentialité complets par utilisateur et des garanties de suppression des messages ne soient mis en œuvre avec des mécanismes de conformité robustes tels que le droit à l'oubli.
La course aux données de l'IA et l'espace publicitaire de recherche
Il est impossible d'analyser cette transition sans examiner la dynamique macroéconomique actuelle des plateformes Internet, de l'intelligence artificielle et des partenariats de recherche. Avec l'explosion des grands modèles de langage (LLM), les données conversationnelles humaines de haute qualité sont devenues l'une des denrées les plus précieuses du web. Les moteurs de recherche se livrent une concurrence acharnée pour faire surface à de nouvelles expériences humaines faisant autorité, tandis que les laboratoires d'IA recherchent constamment des dialogues authentiques pour entraîner les modèles de nouvelle génération.
Des plateformes comme Reddit ont récemment capitalisé sur leurs massifs répertoires de textes générés par les utilisateurs grâce à des accords de licence de données de plusieurs millions de dollars avec les principaux fournisseurs d'IA et conglomérats de recherche. Discord détient l'une des plus grandes réserves inexploitées de données conversationnelles sur Terre. En transformant les messages des serveurs découvrables en documents web publics, Discord stimule non seulement son trafic organique entrant et son entonnoir d'acquisition d'utilisateurs provenant des internautes, mais pose également potentiellement les bases de l'ingestion de données structurées et de partenariats commerciaux dans un paysage de recherche axé sur l'IA.
Que doivent faire les administrateurs de serveurs et les communautés ?
Alors que cette fonctionnalité se rapproche d'un déploiement généralisé, les administrateurs de communauté doivent évaluer de manière proactive les paramètres de leur serveur et établir des directives claires pour leurs membres. La première étape critique consiste à auditer les paramètres de découvrabilité publique du serveur. Les administrateurs gérant des groupes de support sensibles, des espaces de loisirs ou des cohortes industrielles internes doivent déterminer si la visibilité web publique s'aligne sur leur charte communautaire, et être prêts à déclencher le mécanisme de désactivation avant que les robots web ne commencent à archiver systématiquement les fils de discussion historiques.
Pour les communautés qui adoptent l'indexation — telles que les discordes d'outils de développement, les wikis de jeux et les hubs de projets open-source —, les politiques de modération devront être revues. Les canaux indexés publiquement deviendront inévitablement des cibles attrayantes pour les spammeurs, les fermes de liens et les acteurs malveillants recherchant l'autorité de liens provenant de domaines à haute réputation. Le personnel du serveur devra mettre en œuvre une vérification automatisée plus stricte, un filtrage de contenu robuste et un cloisonnement clair des canaux pour s'assurer que seuls les canaux de partage de connaissances désignés sont exposés à l'internet public, tandis que les zones de discussion générale et hors sujet restent isolées.
L'avenir des plateformes de communication ouvertes
L'évolution de Discord vers la visibilité de recherche publique souligne une réalité cyclique de l'infrastructure Internet : les jardins clos finissent par ressentir l'attraction gravitationnelle du web ouvert. Bien que les plateformes centralisées offrent une commodité et des outils d'engagement inégalés, l'utilité du web repose sur des informations interconnectées et universellement accessibles qui survivent à n'importe quelle application propriétaire. Si Discord parvient à équilibrer le consentement et la confidentialité de la communauté avec une réelle indexabilité, il pourra enfin combler le fossé entre le chat communautaire en temps réel et la connaissance web durable.
Source: engadget.com