
IA frontalière locale sur Apple Silicon : le potentiel du Mac Studio M5 Ultra

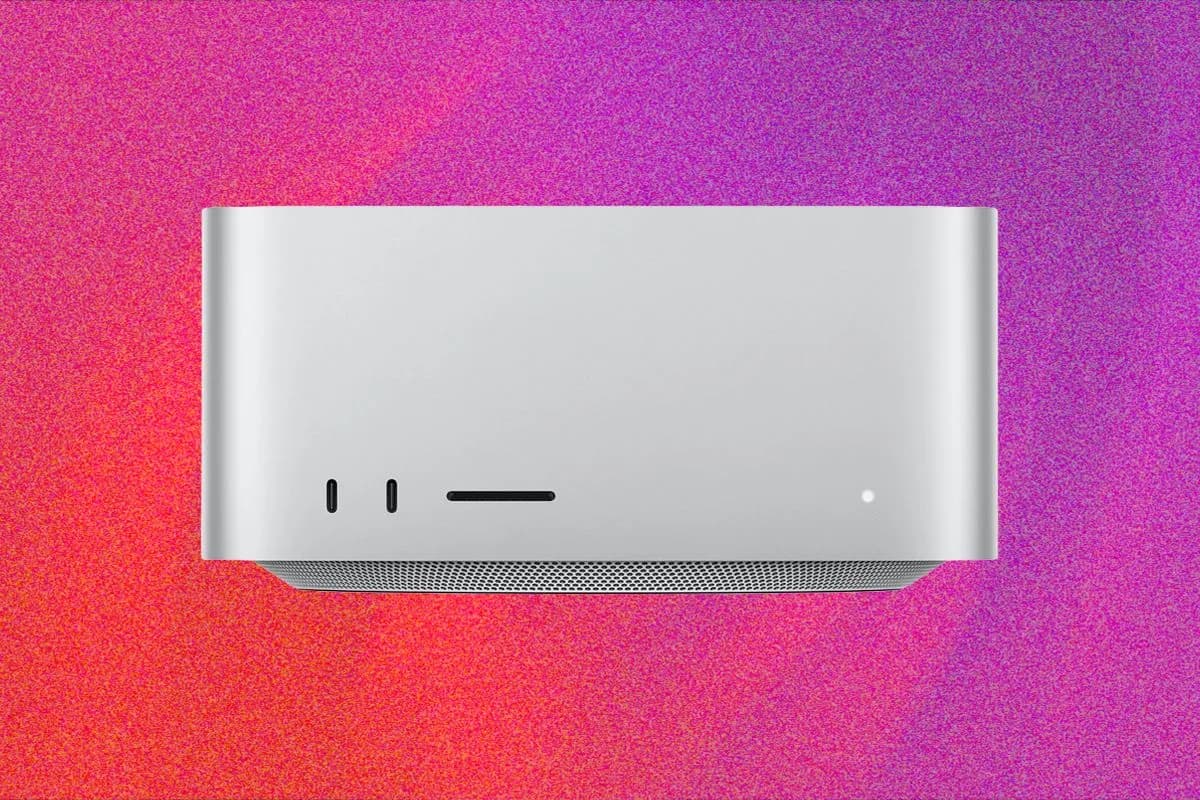
Le passage à l'IA locale dans l'ingénierie logicielle moderne
Ces dernières années, le développement et l'inférence en matière d'intelligence artificielle ont été indissociables du cloud. L'entraînement de modèles frontaliers massifs et même l'exécution d'inférences sur des architectures de pointe exigeaient généralement des grappes de serveurs tentaculaires dotées d'accélérateurs coûteux de qualité professionnelle. Cependant, le paysage matériel subit une transformation silencieuse et profonde. Avec les dernières versions d'Apple Silicon, en particulier la puce M5 Ultra attendue au sein du format Mac Studio, les développeurs découvrent un nouveau paradigme puissant : exécuter des modèles de langage de pointe localement, directement sur le bureau.
Ce changement ne se résume pas à une simple question de commodité ou de réduction des coûts liés aux API cloud. Il représente une évolution fondamentale dans la manière dont les ingénieurs logiciels abordent la confidentialité, la latence et l'architecture des systèmes. Lorsqu'une machine peut héberger et exécuter des réseaux neuronaux complexes de manière native, les barrières à l'expérimentation chutent considérablement. Les ingénieurs n'ont plus besoin de provisionner des ressources externes ni de se soucier des obstacles liés à la conformité des données lorsqu'ils intègrent des bases de code propriétaires dans un assistant intelligent. La station de travail locale évolue pour devenir une véritable centrale d'IA autonome.
Comprendre l'architecture matérielle du M5 Ultra
Au cœur de cette révolution du calcul local se trouve une attention constante portée à la bande passante de la mémoire et à l'architecture unifiée. Les systèmes de bureau traditionnels séparent la mémoire vive (RAM) du système de la VRAM graphique dédiée, créant un goulot d'étranglement notoire lors du transfert incessant des poids de modèles massifs. L'architecture de mémoire unifiée d'Apple élimine fondamentalement cette friction en permettant au processeur (CPU), au processeur graphique (GPU) et au moteur neuronal dédié de partager un pool de mémoire massif et ultra-rapide. Ce choix de conception est le facteur le plus critique permettant aux modèles de langage surdimensionnés de s'intégrer confortablement dans le matériel local.
Bien que les spécifications exactes varient selon les configurations haut de gamme, la philosophie architecturale reste cohérente : des quantités massives de mémoire à haute bande passante associées à des unités de calcul hétérogènes optimisées pour la multiplication matricielle. Pour les développeurs, cela signifie que le Mac Studio peut contenir des modèles quantifiés ou même en précision native qui, traditionnellement, satureraient le matériel grand public standard. La synergie entre l'ingénierie matérielle d'Apple et les frameworks logiciels optimisés — tels que les environnements d'exécution accélérés par Metal — garantit que le nombre de jetons par seconde reste viable pour un véritable développement interactif, plutôt que de subir un traitement par lots d'une lenteur décourageante.
Autonomiser les modèles locaux de pointe
Exécuter un petit modèle distillé localement est une chose, mais la véritable avancée réside dans l'exécution de véritables modèles de classe frontalière sur du matériel local. Alors que les modèles à poids ouverts continuent de rivaliser avec les alternatives propriétaires du cloud en termes de capacités, disposer d'une machine locale capable d'assimiler ces paramètres modifie le calcul de la création logicielle. Les développeurs peuvent désormais affiner, tester et exécuter des boucles de raisonnement complexes hors ligne, totalement déconnectés des télémétries tierces ou des dépendances de disponibilité.
Cette capacité sert d'aperçu inestimable de l'avenir de l'informatique personnelle. À mesure que les systèmes logiciels deviennent de plus en plus autonomes, s'appuyant sur des modèles en arrière-plan pour refactoriser le code, générer des tests et orchestrer les déploiements, la demande en matière de calcul local ne fera que s'accélérer. Disposer d'une machine qui agit comme un bastion privé et sécurisé pour ces modèles de pointe garantit que la propriété intellectuelle reste sur l'appareil tout en récoltant les fruits de l'intelligence artificielle de pointe.
- Élimine la latence des API cloud pour les assistants de codage en temps réel.
- Garde les bases de code propriétaires et les données utilisateur sensibles strictement privées.
- Permet des environnements de développement hors ligne pour les contextes distants ou sécurisés.
Implications sur les flux de travail pour les développeurs logiciels
Pour le programmeur de tous les jours, l'arrivée d'un matériel d'IA local ultra-puissant exige une réévaluation des chaînes d'outils. Les environnements de développement intégrés (IDE) se transforment rapidement en environnements natifs de l'IA où des modèles multimodaux aident à tout, de la planification architecturale au débogage automatisé. Lorsque ces modèles s'exécutent localement via du matériel tel que le Mac Studio M5 Ultra, la boucle de réponse se réduit à des vitesses quasi instantanées, ce qui donne l'impression que l'IA n'est plus un service distant, mais une extension naturelle du compilateur.
De plus, l'exécution locale encourage l'expérimentation. Les développeurs peuvent lancer des modèles locaux spécialisés adaptés à des langages de programmation spécifiques ou à des frameworks internes propriétaires sans s'inquiéter de l'augmentation des factures d'abonnement ou de cloud basées sur les jetons. Cela abaisse la barrière financière et technique à l'adoption de flux de travail d'apprentissage automatique avancés, démocratisant l'accès à des fonctionnalités qui étaient auparavant bloquées derrière les barrières du cloud d'entreprise.
S'attaquer aux goulots d'étranglement : chaleur, énergie et coût
Malgré les remarquables réalisations techniques du silicium Apple haut de gamme, l'IA frontalière locale n'est pas sans défis. L'intégration d'une capacité de calcul immense et de pools de mémoire massifs dans un châssis de bureau compact génère des charges thermiques importantes. Bien que l'architecture thermique d'Apple soit réputée pour son efficacité par rapport aux configurations de stations de travail x86 traditionnelles, les charges de travail d'inférence lourdes et soutenues pousseront les systèmes de refroidissement dans leurs retranchements, soulevant des questions quant à la longévité et aux performances de pointe soutenues sous une charge continue.
Le coût constitue un autre obstacle critique. Les machines configurées avec la mémoire unifiée maximale requise pour héberger des modèles frontaliers massifs affichent un prix élevé de niveau entreprise. Bien qu'elles soient beaucoup moins chères que les grappes de GPU d'entreprise équivalentes, elles représentent tout de même une dépense en capital importante pour les développeurs individuels ou les petites équipes. Équilibrer l'investissement matériel initial par rapport aux coûts permanents d'infrastructure cloud nécessite un calcul financier minutieux pour la direction technique.
L'horizon plus large de l'industrie et de l'écosystème
Les implications de l'IA frontalière localisée s'étendent bien au-delà des bureaux des développeurs individuels, signalant un pivot plus large de l'industrie vers l'intelligence en périphérie (edge intelligence). Alors que les fabricants de semi-conducteurs s'efforcent de construire des appareils clients capables de gérer des charges de travail neuronales complexes, les écosystèmes logiciels s'adaptent rapidement. Les frameworks sont réécrits pour maximiser les accélérateurs spécifiques au matériel, et les communautés open-source investissent massivement dans des techniques de quantization qui réduisent des modèles massifs à des empreintes mémoire plus petites sans sacrifier l'intelligence.
Cette étape matérielle démontre que l'avenir de l'IA ne se cantonnera pas exclusivement à des centres de données massifs et centralisés. Les architectures hybrides — où les tâches de routine, sensibles à la confidentialité ou à faible latence s'exécutent localement sur des appareils tels que le Mac Studio, tandis que les entraînements massifs se déroulent dans le cloud — deviennent la nouvelle norme. Il s'agit d'une phase de transition qui comble le fossé entre l'informatique traditionnelle et les environnements de développement entièrement autonomes et pilotés par l'IA de demain.
Conclusion
La capacité de machines telles que le futur Mac Studio à exécuter localement une IA de pointe marque un tournant décisif pour l'ingénierie logicielle. En mariant des architectures de mémoire unifiée à des environnements d'exécution optimisés, le silicium Apple haut de gamme prouve que les stations de travail locales peuvent servir de véritables hubs privés pour une intelligence artificielle avancée. Bien que les considérations de coût et de thermique persistent, cet aperçu matériel met en évidence une trajectoire inévitable : l'avenir du développement est local, privé et profondément intelligent.
Source: wired.com