
Meta récupère du terrain dans l'IA de pointe avec un nouveau modèle conçu pour la fiabilité des agents

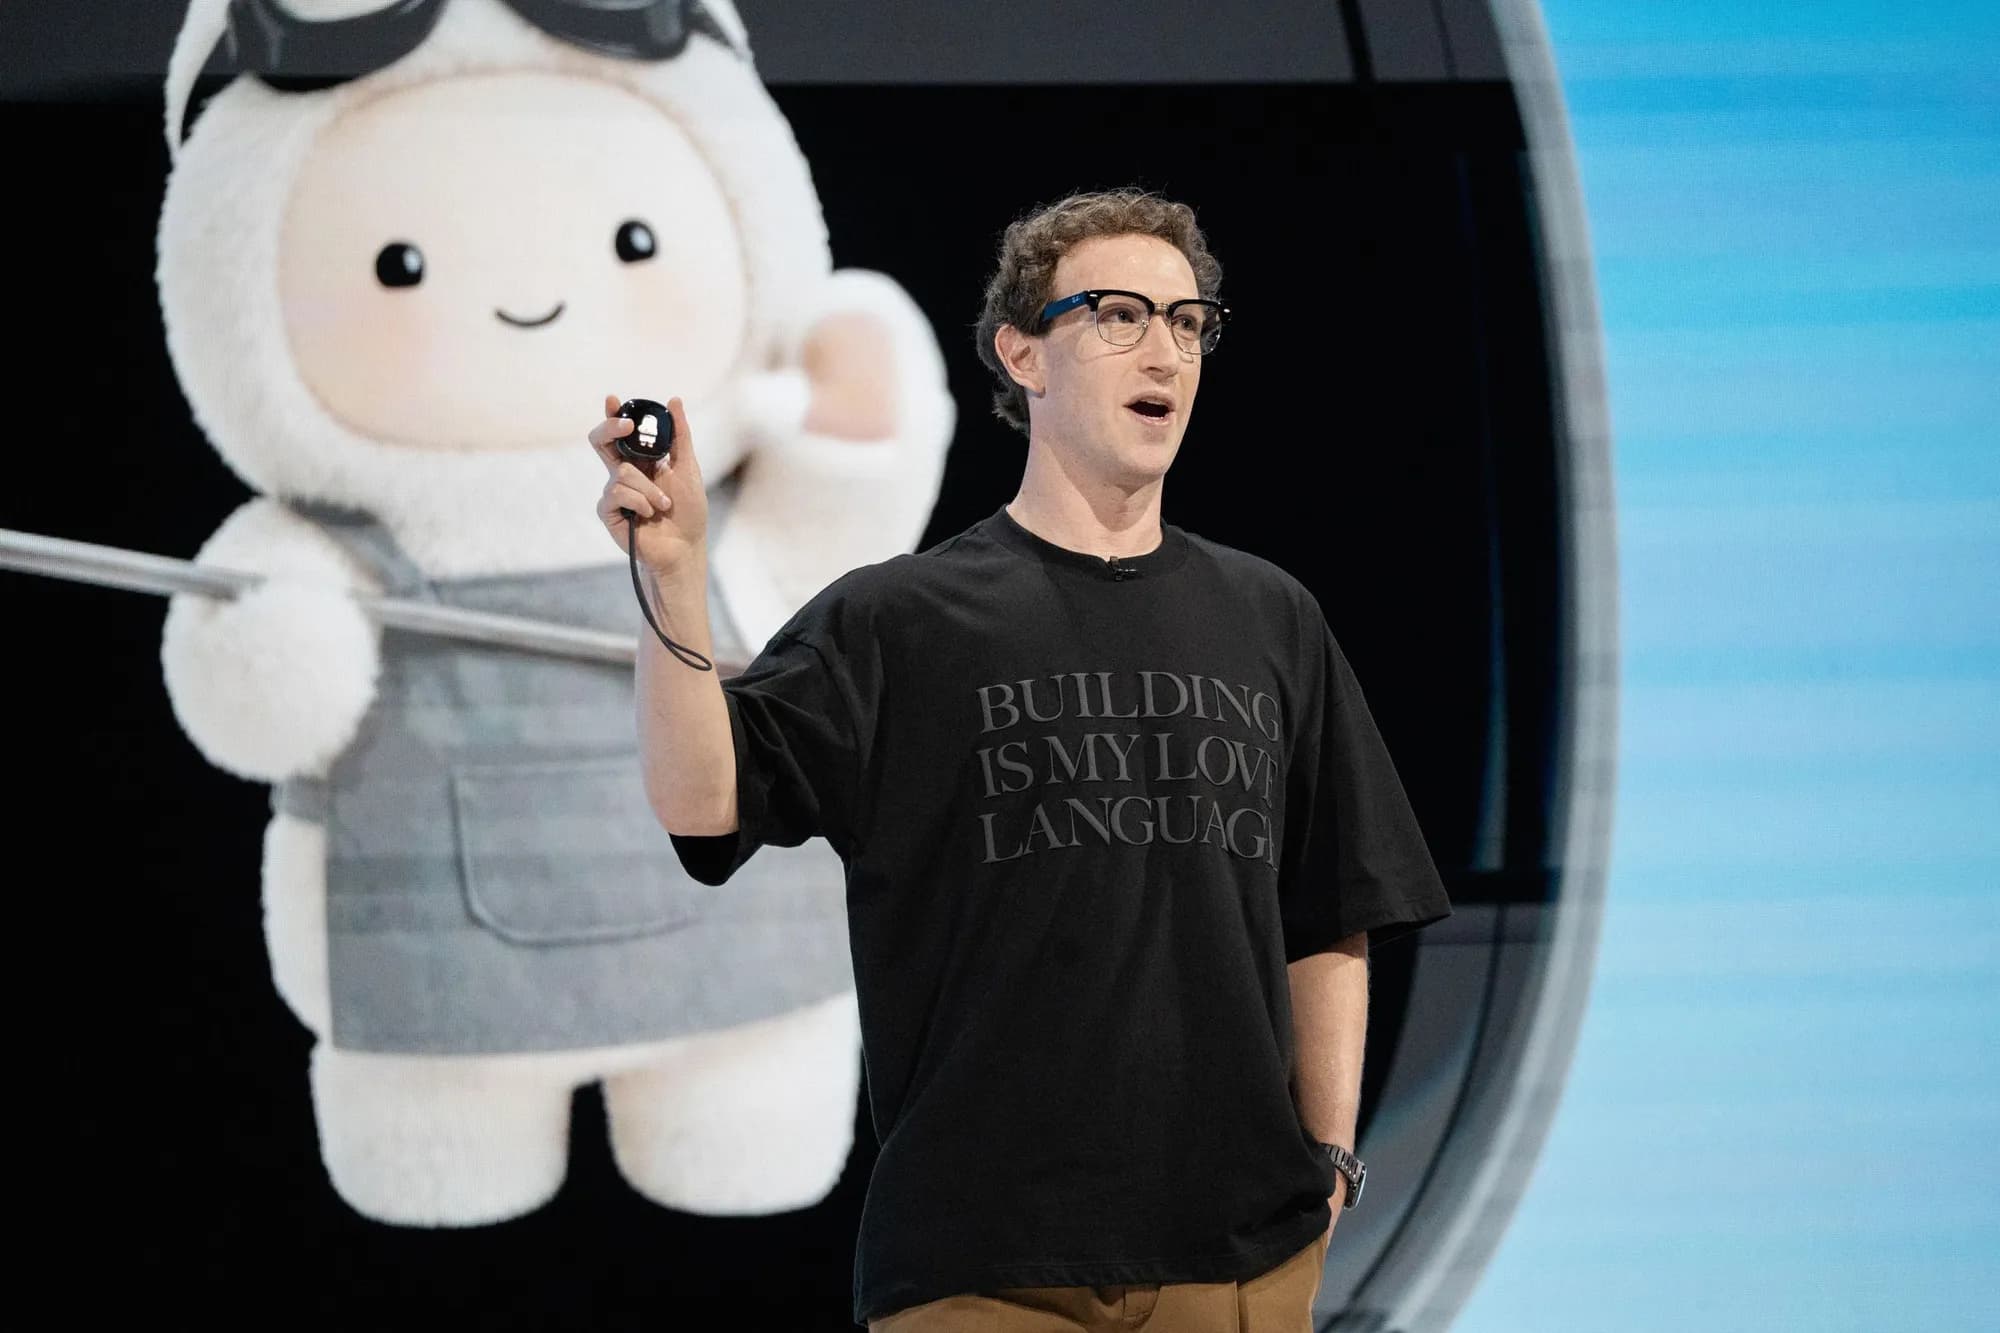
La bataille pour la domination à la pointe absolue de l'intelligence artificielle s'est intensifiée une fois de plus. Meta a franchi le pas avec son modèle le plus ambitieux à ce jour, visant directement les systèmes haut de gamme proposés par ses concurrents propriétaires. Alors que les performances brutes des benchmarks et le nombre de paramètres ont traditionnellement dominé les gros titres lors des lancements de pointe, cette dernière étape marque un changement critique dans l'orientation stratégique : l'exécution pratique et la fiabilité au niveau du système. Plutôt que de se contenter d'optimiser la prose créative ou les capacités conversationnelles générales, Meta a conçu des mécanismes délibérés pour maintenir les agents autonomes multi-étapes ancrés, prévisibles et alignés sur les limites opérationnelles prévues.
La poursuite incessante de la parité de pointe
Au cours des deux dernières années, l'écosystème de l'IA a évolué selon une trajectoire bifurquée bien distincte. D'un côté, des laboratoires propriétaires ont injecté des capacités de calcul sans précédent dans des modèles phares fermés, établissant la référence en matière de raisonnement complexe et de tâches multimodales. De l'autre, Meta a agi comme une force perturbatrice en démocratisant les capacités fondamentales et en prouvant que les écosystèmes de recherche ouverts pouvaient combler rapidement l'écart de performance. Pourtant, à mesure que les équipes logicielles sont passées de la simple génération augmentée par récupération (RAG) à des flux de travail agentiques sophistiqués, le delta de performance entre les modèles grand public et les véritables architectures de pointe est devenu de plus en plus perceptible.
Combler cet écart exige bien plus que des réglages fins progressifs ; cela demande de vastes investissements dans l'infrastructure, des pipelines de curation de données raffinés et de nouveaux paradigmes d'entraînement. La dernière offre de Meta démontre que le géant des réseaux sociaux a la ferme intention de se positionner au coude-à-coude avec les meilleurs de l'industrie. En rivalisant dans les catégories les plus élevées du raisonnement mathématique, de la compréhension à long contexte et de l'interaction autonome avec les outils, cette sortie réaffirme que la concurrence à l'échelle de la pointe est loin d'être une course à un ou deux chevaux. Plus important encore, elle intègre l'intelligence computationnelle de premier plan dans un paradigme architectural où les développeurs disposent d'une plus grande liberté pour construire et itérer.
Domestiquer le comportement autonome : le goulot d'étranglement agentique
Alors que les modèles de langage ont excellé dans les interactions isolées de type requête-réponse, le paysage des développeurs modernes s'est tourné vers les agents autonomes — des systèmes habilités à exécuter des instructions en ligne de commande, à interroger des API, à manipuler des enregistrements de bases de données et à enchaîner des dizaines de décisions interdépendantes. Cependant, cette autonomie a introduit un mode de défaillance aigu : la dérive agentique. Dans les environnements de production, un agent qui interprète mal la sortie intermédiaire d'un outil ou qui aggrave une hallucination précoce peut rapidement sombrer dans des boucles d'exécution catastrophiques, consommant les limites de taux, générant des données corrompues ou tentant des actions non autorisées.
Le nouveau modèle de Meta s'attaque directement à cette vulnérabilité systémique. En intégrant des objectifs d'entraînement spécialisés et des garanties architecturales conçues pour supprimer la dérive agentique hors limites, le modèle met l'accent sur le respect déterministe des contraintes d'outils et des protocoles de vérification. Plutôt que de supposer que le plan généré par le modèle est inconditionnellement valide, les systèmes sous-jacents semblent taillés pour encourager l'autosurveillance, les boucles de validation et le formatage structuré des sorties qui réduisent considérablement les erreurs d'exécution. Pour les équipes cherchant à déployer des assistants automatisés dans des logiciels de production en direct, ces fonctionnalités de transformation stabilisent les flux de travail agentiques pour les faire passer d'expériences de preuve de concept risquées à une infrastructure commercialement viable.
Évolution architecturale : au-delà de la simple fluidité générative
La progression des modèles de fondation s'éloigne de l'ère de la prédiction textuelle purement statistique pour s'orienter vers le raisonnement structuré et l'exécution de politiques orientées vers des objectifs. Construire un modèle qui dirige de manière fiable des agents autonomes implique de lui apprendre à faire des pauses, à s'auto-évaluer et à vérifier les retours d'outils externes par rapport à sa directive principale. Dans les architectures traditionnelles, une réponse inattendue provenant d'une recherche Web intégrée ou d'une requête SQL fait souvent perdre au agent son fil de contexte ou l'amène à inventer des paramètres imaginaires pour forcer la résolution.
Pour résoudre ce problème, les architectures de pointe avancées exploitent l'apprentissage par renforcement amélioré et des techniques d'échantillonnage par rejet axées sur les trajectoires de tâches plutôt que sur les réponses à tour unique. Le modèle est récompensé non seulement pour avoir trouvé une solution, mais aussi pour avoir su reconnaître lorsqu'une sous-tâche a échoué, pour avoir reculé avec élégance et pour avoir ajusté sa stratégie sans intervention de l'utilisateur. En incorporant des barrières de délimitation délibérées directement dans l'espace des pondérations fondamentales et dans les politiques de décodage, les développeurs sont libérés de la rédaction de milliers de lignes d'heuristiques regex fragiles et de chaînes de requêtes défensives juste pour s'assurer que le modèle se comporte de manière prévisible au sein d'un pipeline d'entreprise.
Implications pour les ingénieurs logiciels et les architectes système
Pour les ingénieurs logiciels concevant des piles applicatives modernes, cette étape modifie plusieurs hypothèses de conception fondamentales. Lorsque l'on peut faire confiance aux modèles de fondation pour qu'ils respectent strictement les spécifications de schémas, les limites des API et les paramètres d'accès basés sur les rôles, la complexité du framework d'orchestration qui les accompagne diminue considérablement. Les ingénieurs passent moins de temps à déboguer les plantages d'analyseurs non déterministes et peuvent se concentrer à la place sur les interfaces d'outils spécifiques au domaine et sur la qualité des données.
De plus, des capacités agentiques fiables modifient la manière dont les services back-end sont construits. Considérez plusieurs évolutions pratiques tout au long du cycle de vie du logiciel :
- Correction automatisée du code : Les agents peuvent être chargés d'identifier les tests unitaires défaillants, d'analyser les traces de la pile, de rédiger des correctifs et de vérifier que la construction réussit à travers des monorepos complexes sans risquer d'opérations de référentiel malveillantes.
- Orchestration de microservices résilients : Plutôt que de coder en dur des flux de travail procéduraux rigriges, les développeurs peuvent déployer des coordinateurs autonomes capables de gérer des nouvelles tentatives dynamiques, des inéquations de schémas et des pannes de réseau intermittentes sur les API internes.
- Gouvernance et conformité d'entreprise : Les barrières de confinement natives facilitent grandement l'audit des décisions automatisées et permettent de prouver la conformité aux réglementations strictes en matière de protection des données et de sécurité opérationnelle.
La dynamique des frontières ouvertes et fermées
Au-delà des flux de travail des développeurs individuels, la résurgence de Meta à la pointe de la technologie force un réétalonnage de l'économie globale de l'intelligence artificielle. Lorsque les capacités de pointe sont concentrées exclusivement au sein d'API commerciales fermées, l'industrie logicielle fait face à des risques distincts de dépendance vis-à-vis d'un fournisseur, à une hausse des prix des inférences et à des modifications de politiques opaques. Les organisations des secteurs hautement réglementés — tels que la finance, la santé et les télécommunications — se trouvent souvent dans l'incapacité de déployer des points de terminaison propriétaires exclusivement inféodés au cloud en raison de contraintes strictes de souveraineté des données.
En faisant progresser les capacités de pointe tout en fournissant des modèles opérationnels adaptés aux entreprises, Meta exerce une pression à la baisse sur les prix des API sur l'ensemble du marché tout en accélérant l'innovation ouverte. Les équipes qui comptaient auparavant sur des modèles de pointe fermés comme moteur de raisonnement par défaut disposent désormais d'une alternative viable qui peut soit être auto-hébergée sur des accélérateurs privés, soit être consultée via des partenaires d'hébergement multi-cloud. Cette concurrence favorise un substrat technologique plus sain où aucune entité d'entreprise unique ne dicte les normes du calcul autonome.
La voie vers l'autonomie de qualité production
L'arrivée de la dernière centrale de pointe de Meta souligne une phase de maturation pour l'industrie de l'IA. L'enthousiasme initial entourant la fluidité conversationnelle a fait place à un accent pragmatique sur la fiabilité opérationnelle, le raisonnement vérifiable et l'action autonome robuste. Alors que les modèles de fondation prennent de réelles responsabilités au sein de l'écosystème logiciel mondial, la mesure du succès n'est plus la fluidité avec laquelle un modèle écrit, mais la sécurité et la prévisibilité avec lesquelles il agit. En privilégiant des barrières de sécurité qui maintiennent les systèmes autonomes sur la bonne voie, cette nouvelle génération de modèles marque une étape décisive vers des agents d'IA en lesquels les ingénieurs peuvent avoir pleinement confiance en production.
Source: wired.com