
La science de la mauvaise audition : pourquoi les assistants vocaux échouent et comment les systèmes modernes s'adaptent

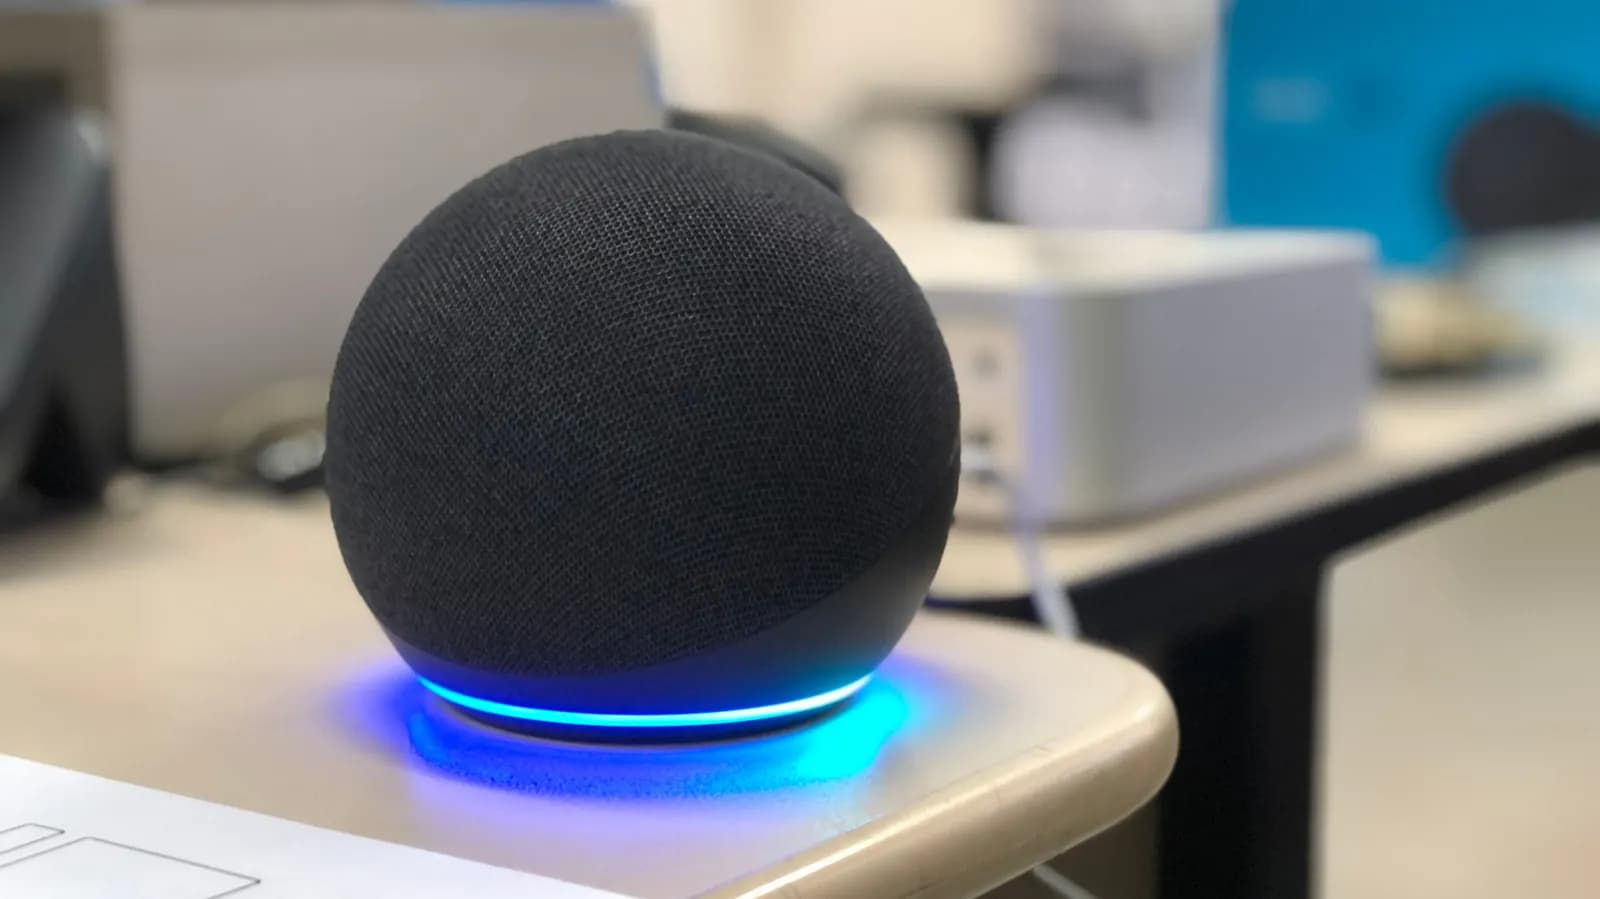
La frustration de l'assistant intelligent insensible
Pendant plus d'une décennie, les enceintes intelligentes ont occupé une place de choix sur les comptoirs de cuisine, les tables de chevet et les étagères de salon. Promettant une informatique sans friction grâce à la parole naturelle, ces appareils ambiants ont été salués comme l'avenir de l'informatique ambiante. Pourtant, presque tous les utilisateurs partagent une expérience familière et exaspérante : répéter une simple commande trois fois, chaque itération étant prononcée plus fort et avec une articulation exagérée, pour que l'enceinte diffuse un morceau sans rapport ou annonce qu'elle ne peut pas répondre à cette demande pour le moment.
Alors que le matériel marketing dépeint la reconnaissance vocale comme une intuition sans effort, la réalité sous-jacente est un pipeline multi-étapes précaire de traitement du signal, de modélisation acoustique, de reconnaissance automatique de la parole (ASR) et de compréhension du langage naturel (NLU). Lorsqu'un seul nœud de cette chaîne rencontre des conditions limites — telles que la réverbération de la pièce, des bruits de fond conflictuels ou des formulations ambiguës —, toute l'interaction s'effondre. Comprendre pourquoi les enceintes intelligentes échouent nécessite d'analyser les obstacles physiques et algorithmiques que les ingénieurs doivent surmonter, ainsi que les ajustements pratiques que les utilisateurs peuvent faire pour combler le fossé.
La réalité acoustique : la physique avant les algorithmes
Avant qu'un modèle d'intelligence artificielle ne tente de décoder le langage humain, le matériel doit capturer une forme d'onde lisible. C'est un défi immense pour un appareil de la taille d'une tasse de café. Dans un environnement domestique typique, les ondes sonores ne se déplacent pas dans le vide ; elles rebondissent sur les cloisons sèches, les planchers en bois franc et les fenêtres en verre, créant des réflexions acoustiques complexes et des décalages de phase connus sous le nom de réverbération. En plus de cela, les enceintes intelligentes émettent fréquemment des sons forts à partir de leurs propres haut-parleurs intégrés tout en écoutant simultanément un faible murmure de l'autre côté de la pièce.
Les ingénieurs matériels atténuent cela grâce à des réseaux de microphones et à des techniques de traitement du signal numérique (DSP), au premier rang desquelles l'annulation d'écho acoustique (AEC) et la formation de faisceaux adaptative. L'AEC soustrait le propre signal audio sortant de l'appareil du flux du microphone entrant afin que l'enceinte ne s'écoute pas elle-même. Pendant ce temps, la formation de faisceaux calcule les minuscules différences de microsecondes entre le moment où une onde sonore frappe le microphone A et le microphone B, façonnant efficacement un « cône d'écoute » électronique concentré sur la position spatiale de l'orateur. Si l'enceinte est placée trop près d'un mur, coincée à l'intérieur d'une bibliothèque encombrée ou placée juste à côté du bourdonnement d'un appareil, ces algorithmes spatiaux se dégradent rapidement, transmettant un son corrompu en aval dans le pipeline de reconnaissance.
Le piège du mot-clé d'activation : la détection en périphérie à ultra-basse puissance
L'un des points de défaillance les plus fréquents se produit avant même que le cloud ne sache qu'une interaction a commencé. Étant donné que la transmission continue 24h/24 et 7j/7 de l'audio vers des serveurs distants serait une catastrophe pour la vie privée et une charge de bande passante impossible, les appareils intelligents s'emparent de moteurs de mots-clés d'activation légers intégrés à l'appareil. Ces minuscules réseaux de neurones s'exécutent en continu sur des microcontrôleurs à ultra-basse puissance, ne recherchant que des signatures acoustiques spécifiques telles que « Hey Google » ou « Alexa ».
Pour maintenir l'efficacité de l'appareil et protéger les limites thermiques ou de batterie, ces modèles localisés doivent fonctionner avec un nombre minimal de paramètres. Cette contrainte de calcul force un compromis délicat entre l'acceptation erronée (déclenchement accidentel par le dialogue télévisé) et le rejet erroné (ignorance d'un véritable utilisateur). Lorsqu'un utilisateur parle avec une nouvelle inflexion, parle trop vite ou attrape le modèle lors d'un vidage momentané du tampon DSP, le moteur de mot-clé abandonne complètement le déclenchement. Du point de vue de l'utilisateur, l'appareil semble cassé ou sourd, alors qu'en réalité il se protégeait simplement contre les activations faussement positives dans des contraintes de ressources sévères.
Des ondes sonores aux jetons : les pièges de l'ASR et du NLU
Une fois que le mot-clé déclenche la capture d'une charge utile vocale, l'audio numérisé est traité par la reconnaissance automatique de la parole (ASR) pour convertir les formes d'onde phonétiques en texte. Cette transcription est ensuite injectée dans un moteur de compréhension du langage naturel (NLU), qui classe l'intention et extrait les paramètres de créneau pertinents (par exemple, intention : 'SetTimer', créneau : 'Duration=10min'). Malgré des progrès monumentaux dans l'apprentissage profond, les modèles de conversion de la parole en texte ont encore énormément de mal avec l'ambiguïté phonétique, la co-articulation et divers dialectes régionaux.
Les assistants vocaux traditionnels basés sur le cloud ont été construits sur des architectures de classification d'intention relativement rigides. Contrairement aux grands modèles de langage (LLM) modernes qui généralisent la signification contextuelle à travers de larges fils de conversation, les modèles NLU d'assistants intelligents classiques comparent les énoncés à des modèles sémantiques prédéfinis. Si une commande diverge ne serait-ce que légèrement de la distribution d'entraînement — comme dire « éteins la lampe du salon » au lieu de « éteins la lumière du salon » —, le classificateur peut soit échouer silencieusement, soit sélectionner une mauvaise interprétation catastrophique. L'illusion d'intelligence se brise parce que le système fonctionne sur une correspondance de motifs étroite plutôt que sur un raisonnement cognitif.
Atténuations pratiques : comment les utilisateurs peuvent optimiser la captation vocale
Bien que les architectures d'interface vocale continuent d'évoluer, les utilisateurs peuvent augmenter considérablement le taux de réussite de leur enceinte intelligente en comprenant les contraintes physiques de l'appareil. L'ajustement le plus percutant implique un placement physique stratégique. Élever l'enceinte loin des coins réfléchissants, la maintenir à au moins quelques mètres des appareils à fort bruit et assurer une ligne de vue dégagée vers les zones d'assise principales empêche la distorsion de formation de faisceau et nettoie radicalement le signal acoustique entrant.
En plus du placement du matériel, les utilisateurs peuvent optimiser les profils logiciels offerts par les plates-formes modernes :
- Réentraînement du profil vocal : La plupart des plates-formes de l'écosystème permettent aux utilisateurs d'entraîner un profil vocal personnalisé. Réenregistrer des échantillons vocaux dans la pièce réelle où vit l'enceinte — plutôt que dans un bureau silencieux — fournit au modèle des caractéristiques de référence ambiantes réalistes.
- Levée d'ambiguïté du nom des appareils : Les pipelines NLU s'étouffent en cas de collisions phonétiques. Donner aux appareils domestiques intelligents des noms distincts et phonétiquement divergents (par exemple, « Lampe de lecture » au lieu d'avoir « Lumière 1 » et « Lumière 2 ») réduit considérablement les erreurs de classification du remplissage de créneaux.
- Rythme et intonation : Parler à un rythme de conversation naturel plutôt qu'à des cadences robotiques anormalement lentes produit un audio qui s'aligne plus étroitement sur les ensembles de données d'entraînement des moteurs ASR commerciaux.
L'horizon des développeurs : LLM locaux et intelligence périphérique multimodale
Pour les ingénieurs logiciels et les développeurs de systèmes embarqués, l'ère de l'architecture vocale fragile pilotée par des mots-clés touche à sa fin. L'industrie opère actuellement une transition majeure vers de petits modèles de langage sur l'appareil (SLM) et le traitement de la parole générative. En s'éloignant des pipelines fragiles en deux étapes ASR-plus-correspondance-d'intention et en se tournant vers des modèles de fondation parole-à-parole de bout en bout, les futurs assistants analyseront l'intention conversationnelle de manière fluide, s'adaptant aux hésitations, aux corrections et aux instructions complexes à clauses multiples sans réinitialiser le contexte.
Simultanément, l'adoption de normes multiplateformes telles que Matter et de frameworks d'exécution locaux découple la fiabilité de la maison intelligente de la latence du cloud. Lorsque le traitement vocal s'exécute localement sur des unités de traitement neural (NPU) dédiées intégrées dans du silicium plus récent, les temps de réponse passent de quelques secondes à quelques millisecondes, et les taux d'échec associés aux paquets réseau intermittents sont éliminés. Les développeurs concevant la prochaine génération d'interfaces vocales ne seront plus piégés par la conception d'arbres de commandes vocales rigides ; à la place, ils concevront des agents multimodaux conscients du contexte capables de comprendre l'intention de l'utilisateur même à travers une formulation imparfaite et des conditions acoustiques imparfaites.
Combler le fossé de l'utilisabilité vocale
Les pannes d'enceintes intelligentes sont rarement aléatoires ; elles sont la conséquence directe de barrières acoustiques physiques, de contraintes matérielles et d'architectures de compréhension du langage existantes qui se heurtent aux environnements acoustiques chaotiques des foyers humains. En positionnant les appareils de manière réfléchie et en établissant des configurations claires et distinctives, les utilisateurs peuvent contourner bon nombre des pièges techniques d'aujourd'hui. Pendant ce temps, la convergence de l'accélération matérielle de pointe et des modèles de langage avancés promet enfin d'élever les assistants vocaux du rang d'analyseurs de commandes capricieux à celui de véritables compagnons informatiques ambiants intuitifs.
Source: engadget.com