
Quand la géopolitique rencontre le silicium : comment les attaques contre les infrastructures transforment l'entraînement de l'IA

La collision entre conflit physique et infrastructure numérique
Pendant des décennies, la communauté du génie logiciel a considéré l'infrastructure comme quelque chose de largement abstrait. Nous configurons nos clusters sur AWS, Google Cloud ou Azure, et nous pensons que notre matériel flotte en toute sécurité quelque part dans le cloud — ou du l'est du moins bien à l'abri au sein de centres de données en béton lourdement gardés et sans caractéristiques distinctives. Cependant, les développements récents rappellent brutalement que le logiciel repose entièrement sur des substrats physiques. Lorsque les conflits géopolitiques débordent sur le domaine technologique, la réalité tangible des centres de données, des réseaux électriques et du matériel spécialisé se retrouve soudainement sur le devant de la scène.
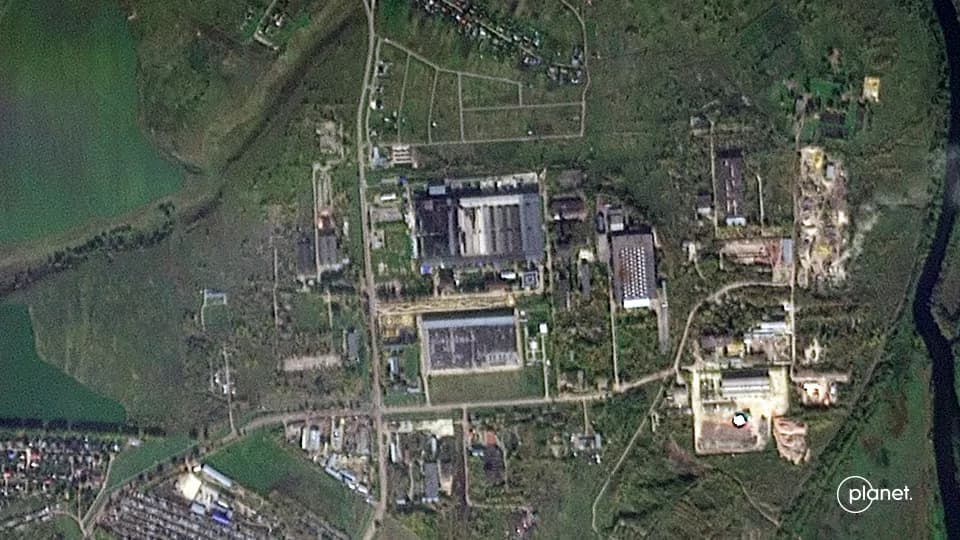
Cette dynamique a récemment été mise en exergue lorsque des frappes de drones ciblées ont touché une importante installation de données en Russie, abritant spécifiquement les clusters de haute performance utilisés par Yandex — souvent surnommé le « Google russe ». Alors que le monde numérique se focalise souvent sur les percées algorithmiques, les lois d'échelle des paramètres et les chaînes d'approvisionnement logicielles, cet événement met en lumière un tout autre ensemble de vulnérabilités. À mesure que les modèles d'intelligence artificielle deviennent des actifs nationaux profondément stratégiques, les installations physiques qui les entraînent sont de plus en plus exposées aux frictions de la guerre physique.
Au cœur du matériel qui alimente l'IA moderne
Pour comprendre l'importance du ciblage d'une installation telle que celle utilisée par Yandex, il faut examiner de près ce qu'implique l'entraînement de modèles fondamentaux modernes. L'entraînement de systèmes d'apprentissage automatique à grande échelle ne ressemble pas à l'exécution de serveurs web standard ou de microservices. Il exige une puissance de traitement massive et parallèle, utilisant des réseaux denses de GPU ou d'unités de traitement tensoriel spécialisées, des interconnexions à haut débit telles qu'InfiniBand, ainsi qu'une alimentation électrique continue et un refroidissement liquide immenses.
Ces clusters informatiques spécialisés sont notoirement difficiles à acquérir, configurer et maintenir dans les meilleures conditions, et plus encore dans un environnement contraint par des sanctions internationales et des goulets d'étranglement dans la chaîne d'approvisionnement. Lorsqu'une installation abritant ces supercalculateurs haut de gamme subit des dommages physiques, la perte va bien au-delà de la simple gestion immobilière. Elle représente une perturbation grave d'un capital informatique rare. Remplacer le silicium endommagé, reconstruire les circuits de refroidissement à eau et rétablir les délicats tissus réseau à faible latence constitue un défi d'ingénierie monumental, même sans perturbations extérieures.
Le pivot stratégique vers une infrastructure d'IA souveraine
Ces dernières années, le concept d'« IA souveraine » a dominé les discussions des conseils d'administration du monde entier. Les gouvernements et les grands champions technologiques régionaux ont réalisé que dépendre de fournisseurs de cloud étrangers ou de matériel importé crée des dépendances stratégiques inacceptables. Par conséquent, les nations ont injecté des ressources immenses dans la construction de centres de données nationaux, la conception de puces locales et la sécurisation de voies indépendantes pour progresser dans l'apprentissage automatique.
Cependant, cette volonté de centralisation et d'autonomie introduit son propre paradoxe architectural. En concentrant une quantité massive de puissance de calcul dans de grandes installations centralisées pour réaliser des économies d'échelle lors de l'entraînement de modèles gigantesques, les organisations créent par inadvertance des cibles de grande valeur et hautement visibles. Alors que les architectures informatiques en périphérie (edge computing) sont résilientes précisément parce qu'elles n'ont pas de point de défaillance unique, l'IA générative moderne exige exactement le contraire : des clusters hyper-concentrés et étroitement couplés via des réseaux à ultra-faible latence.
Vulnérabilités de la chaîne d'approvisionnement et coût des temps d'arrêt
Pour les développeurs et les ingénieurs en infrastructure, les implications de ces menaces physiques se répercutent sur des considérations plus larges de résilience et de reprise après sinistre. Traditionnellement, les plans de reprise après sinistre dans les logiciels d'entreprise tiennent compte des coupures de fibres optiques, des pannes de courant, des bugs logiciels et même des cyberattaques ciblées telles que les campagnes DDoS sophistiquées ou les rançongiciels. Les architectes système conçoivent des basculements multi-régions actif-actif pour gérer ces perturbations logicielles ou au niveau du réseau en toute transparence.
Pourtant, les modèles de haute disponibilité traditionnels peinent lorsque les nœuds de calcul fondamentaux sont physiquement détruits ou rendus inaccessibles en raison d'actions cinétiques. Contrairement aux machines virtuelles standard qui peuvent être lancées dans une autre zone de disponibilité en quelques minutes, la reconstruction d'un cluster d'entraînement de plusieurs mégawatts nécessite du matériel physique dont l'approvisionnement, l'expédition et la mise en service peuvent prendre des mois. Cela introduit une nouvelle variable inquiétante dans les cadres de gestion des risques pour les organisations opérant dans ou à proximité de régions volatiles.
Les leçons plus larges pour les écosystèmes technologiques mondiaux
Alors que l'intelligence artificielle cimente son statut d'infrastructure critique — comparable aux réseaux de télécommunications, aux systèmes financiers et aux pipelines énergétiques —, les règles régissant sa sécurité doivent évoluer. Les entreprises technologiques et les opérateurs de plateformes sont contraints de faire face à des menaces de sécurité physique qui relevaient auparavant exclusivement du domaine des stratèges militaires ou des agences de protection des infrastructures critiques. Cette intersection entre code et conflit soulève des questions difficiles sur l'avenir du développement technologique mondialisé.
De plus, ces événements pourraient accélérer les changements dans la manière dont les modèles sont entraînés et distribués. Si les centres de supercalculateurs centralisés font face à des risques physiques croissants, l'industrie pourrait assister à une poussée encore plus forte vers des méthodes d'entraînement décentralisées, l'apprentissage fédéré ou des architectures plus empreintes d'efficacité qui réduisent l'empreinte matérielle absolue nécessaire pour atteindre des performances de pointe. Lorsque le matériel devient un véritable champ de bataille, l'optimisation cesse d'être une simple préférence d'ingénierie pour devenir une stratégie de survie.
Réflexions finales
L'incident concernant le centre de données Yandex marque une étape qui donne à réfléchir dans l'évolution de la technologie moderne. Il comble brutalement le fossé entre les mondes virtuels que nous construisons et la réalité physique qui les soutient. Alors que les développeurs et les architectes se tournent vers l'avenir, reconnaître la fragilité physique de nos fondations numériques sera tout aussi crucial que d'écrire du code résilient ou de mettre à l'échelle des réseaux de neurones.
Source: arstechnica.com